Logging trên ClickHouse thay Elasticsearch: schema, pipeline, tiering S3 và retention một năm
Bản thiết kế thực tế để chuyển log từ Elasticsearch sang ClickHouse: Vector và Kafka để ingest, schema theo chuẩn OpenTelemetry với text index mới, tiering sang S3 bằng TTL, tìm kiếm đa region trên một UI, và những cái bẫy hay gặp khi chạy production.
Elasticsearch tìm kiếm rất giỏi. Vấn đề là phần lớn log không phải bài toán tìm kiếm. Log chỉ ghi thêm, sắp theo thời gian, khổng lồ và hiếm khi được đọc. Phần lớn lượt đọc là “cho tôi xem lỗi của service X trong 30 phút qua” hoặc “mỗi phút bao nhiêu 5xx”. Kết cục là bạn trả tiền cho inverted index trên mọi field, cho JVM heap, cho replica trên đĩa nhanh và cho một ILM policy cần người trông. Đổi lại là relevance scoring mà chẳng ai dùng cho dòng log.
ClickHouse lật ngược bài toán. Nó là cơ sở dữ liệu dạng cột, nên một bảng log trở thành tập các cột nén rất tốt, được sắp theo service và thời gian. Query chỉ đọc những cột nó cần, phân tích bằng SQL, và dữ liệu cũ trôi xuống S3 ngay trong cùng một bảng. Từ ClickHouse 26.2, full-text text index đã GA, nên tìm theo token trong nội dung log là tính năng chính thức chứ không còn là mẹo chữa cháy.
Bài này là bản thiết kế tôi sẽ dùng cho một cuộc migration production: pipeline, schema, tiering sang S3, tìm kiếm đa region, lộ trình chuyển đổi và các cái bẫy.
Trong một lần migration production theo đúng mô hình này, khoảng 10 TB log/ngày, retention một năm, tổng chi phí logging giảm khoảng 60% so với cụm Elasticsearch cũ. Con số của bạn sẽ tuỳ vào hình dạng log và kiểu query. Những cơ chế bên dưới là thứ tạo ra mức tiết kiệm đó.
Vì sao log hợp với cơ sở dữ liệu dạng cột
| Elasticsearch | ClickHouse | |
|---|---|---|
| Mô hình lưu trữ | Document + inverted index mỗi field + doc values + _source |
Các cột sắp theo ORDER BY, nén theo từng cột |
| Độ nén với log | Vừa phải, index còn cộng thêm dung lượng | Cao: giá trị giống nhau nằm cạnh nhau, codec ZSTD và Delta |
| Tìm kiếm | Full-text, scoring, fuzzy | Tìm theo token bằng text index, LIKE, regex; không scoring |
| Phân tích | Aggregations DSL | SQL đầy đủ, join, window function |
| Retention / tiering | ILM, hot-warm-cold, searchable snapshot | Partition theo ngày + TTL … TO VOLUME / DELETE |
| Áp lực bộ nhớ | JVM heap, field data, số lượng shard | Không có JVM; bộ nhớ tính theo query, giới hạn được bằng setting |
Công bằng mà nói, Elasticsearch có frozen tier và searchable snapshot. Nếu bạn thật sự cần xếp hạng theo độ liên quan, fuzzy match hay “ý bạn là” trên log, nó vẫn là công cụ tốt hơn. Còn với kiểu “lọc theo service, thời gian, severity, rồi grep một token, rồi đếm”, ClickHouse làm cùng việc đó với ít byte trên đĩa và ít CPU hơn nhiều.
Kiến trúc
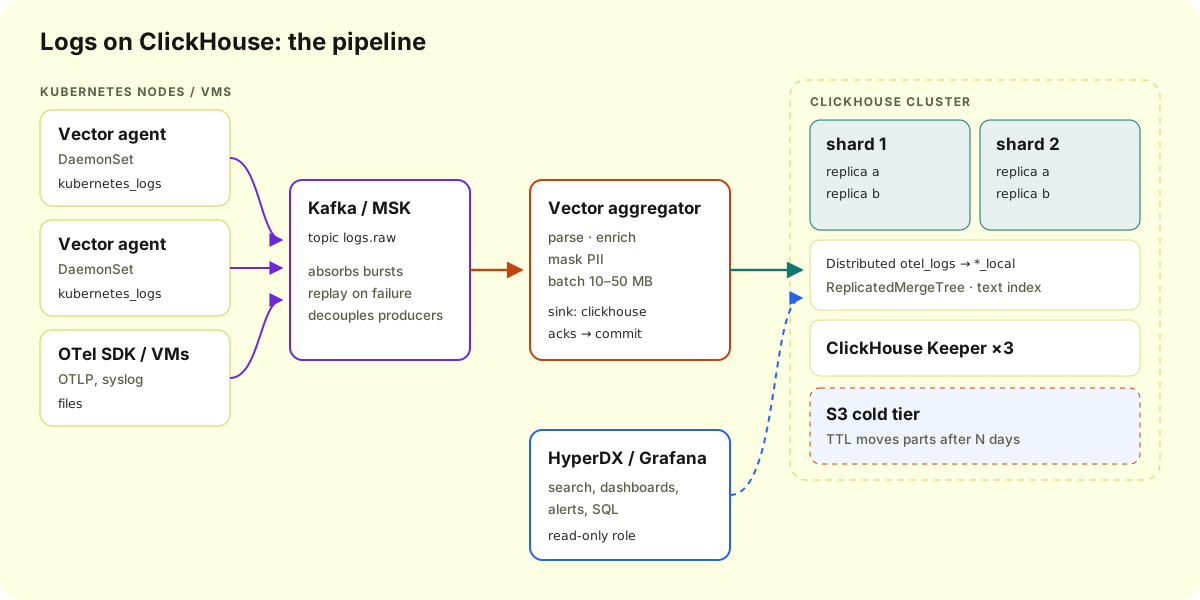
- Vector agent chạy dạng DaemonSet (hoặc trên VM), đọc log container và đẩy event thô vào Kafka. Agent làm càng ít càng tốt, để một transform lỗi không thể làm sập node.
- Kafka / MSK là bộ giảm xóc. Khi ClickHouse chậm hoặc đang nâng cấp, log dồn lại trong Kafka chứ không dồn trên node. Khi parser có bug, bạn còn có thể replay lại một khoảng thời gian.
- Vector aggregator đọc từ Kafka, parse và làm giàu dữ liệu, che PII, rồi ghi vào ClickHouse theo lô lớn. Với acknowledgement end-to-end, offset Kafka chỉ được commit sau khi ClickHouse đã nhận lô.
- ClickHouse: N shard × 2 replica
ReplicatedMergeTree, một bảngDistributedở trên, và ClickHouse Keeper (3 node) giữ metadata replication. - HyperDX (UI trong ClickStack, bộ observability của ClickHouse) hoặc Grafana để tìm kiếm, làm dashboard và cảnh báo. HyperDX nhận cả cú pháp kiểu Lucene lẫn SQL, và liên kết log, trace, metric với nhau.
Nếu bạn bắt đầu từ đầu và đã dùng OpenTelemetry, OTel collector của ClickStack có thể thay Vector. Schema bên dưới theo đúng hình dạng log của OpenTelemetry, nên sau này đổi qua lại vẫn được.
Schema
Phần lớn hiệu năng nằm ở schema, nên đây là chỗ đáng làm cho đúng. Dưới đây là bảng local theo hình dạng OTel, chỉnh từ hướng dẫn schema của chính ClickHouse:
CREATE TABLE otel.otel_logs_local ON CLUSTER logs
(
    Timestamp          DateTime64(9) CODEC(Delta(8), ZSTD(1)),
    TraceId            String CODEC(ZSTD(1)),
    SpanId             String CODEC(ZSTD(1)),
    SeverityText       LowCardinality(String) CODEC(ZSTD(1)),
    SeverityNumber     UInt8,
    ServiceName        LowCardinality(String) CODEC(ZSTD(1)),
    Body               String CODEC(ZSTD(1)),
    ResourceAttributes Map(LowCardinality(String), String) CODEC(ZSTD(1)),
    LogAttributes      Map(LowCardinality(String), String) CODEC(ZSTD(1)),

    -- các attribute hay dùng được đưa thành cột thật
    K8sNamespace LowCardinality(String) MATERIALIZED ResourceAttributes['k8s.namespace.name'],
    HttpStatus   UInt16 MATERIALIZED toUInt16OrZero(LogAttributes['http.status_code']),

    INDEX idx_body     Body    TYPE text(tokenizer = splitByNonAlpha),
    INDEX idx_trace_id TraceId TYPE bloom_filter(0.001) GRANULARITY 1
)
ENGINE = ReplicatedMergeTree('/clickhouse/tables/{shard}/{database}/{table}', '{replica}')
PARTITION BY toDate(Timestamp)
ORDER BY (ServiceName, SeverityText, toUnixTimestamp(Timestamp), TraceId)
TTL toDateTime(Timestamp) + INTERVAL 7 DAY TO VOLUME 'cold',
    toDateTime(Timestamp) + INTERVAL 365 DAY DELETE
SETTINGS storage_policy = 'hot_cold',
         ttl_only_drop_parts = 1;

CREATE TABLE otel.otel_logs ON CLUSTER logs AS otel.otel_logs_local
ENGINE = Distributed(logs, otel, otel_logs_local, rand());
Lý do của từng lựa chọn:
ORDER BY (ServiceName, SeverityText, time, …): sort key cũng chính là primary index. Đặt các cột ít giá trị mà bạn luôn lọc lên đầu. Khi đó một queryServiceName = 'checkout' AND SeverityText = 'ERROR'bỏ qua phần lớn bảng mà không cần đọc. Thứ tự này cũng quyết định độ nén, vì các giá trị service và severity giống nhau xếp thành những dải dài.PARTITION BY toDate(Timestamp): mỗi ngày một partition. Đủ thô để không sinh ra hàng nghìn part, và giúp retention xoá được nguyên cả ngày.LowCardinality(String)cho service, severity và key của attribute: mã hoá theo dictionary, nên nhỏ hơn và lọc nhanh hơn.- Codec:
Delta + ZSTDcho timestamp (các giá trị liên tiếp chênh nhau rất ít),ZSTDcho phần còn lại. ZSTD là codec đa dụng được khuyến nghị cho dữ liệu log. Mapcho attribute, cột materialized cho key hay dùng: Map linh hoạt, nhưng đọcLogAttributes['x']là đọc cả cột map. Nếu dashboard lọc theo namespace hay HTTP status cả ngày, hãy đưa các key đó thành cột thật. Giá trị trong Map là chuỗi, nên mới cầntoUInt16OrZero.textindex trênBody: inverted index trên các token của message, tách theo ký tự không phải chữ hoặc số. Nó thay cho các skip index dạng bloom filtertokenbf_v1/ngrambf_v1cũ, vốn không còn được ClickHouse khuyến nghị cho việc này.Distributed(…, rand()): chia đều lượng insert. Nếu muốn toàn bộ log của một trace nằm trên một shard, hãy shard theocityHash64(TraceId).
textindex GA từ ClickHouse 26.2. Ở các bản cũ hơn nó là experimental/beta và phải bật bằng setting, nên kiểm tra tài liệu đúng phiên bản của bạn trước khi dựa vào nó. Thêm index vào bảng có sẵn bằngALTER TABLE … ADD INDEXchỉ áp dụng cho part mới, cho đến khi bạn chạyMATERIALIZE INDEX.
Tiering: NVMe nóng, S3 lạnh, rồi xoá
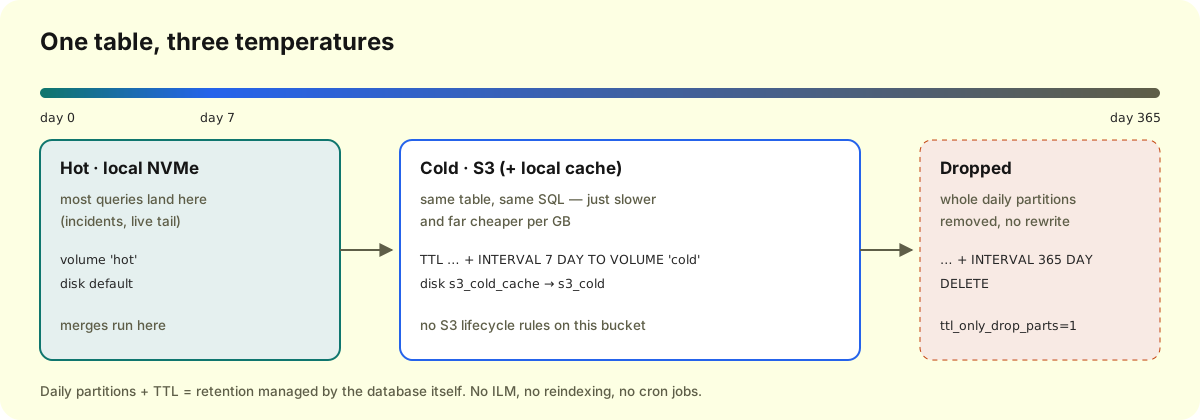
Storage policy, đặt thành file cấu hình trên mọi server (/etc/clickhouse-server/config.d/storage.xml):
<clickhouse>
  <storage_configuration>
    <disks>
      <s3_cold>
        <type>s3</type>
        <endpoint>https://my-logs-cold.s3.ap-southeast-1.amazonaws.com/{shard}/{replica}/</endpoint>
        <use_environment_credentials>true</use_environment_credentials>
        <metadata_path>/var/lib/clickhouse/disks/s3_cold/</metadata_path>
      </s3_cold>
      <s3_cold_cache>
        <type>cache</type>
        <disk>s3_cold</disk>
        <path>/var/lib/clickhouse/disks/s3_cold_cache/</path>
        <max_size>200Gi</max_size>
      </s3_cold_cache>
    </disks>
    <policies>
      <hot_cold>
        <volumes>
          <hot><disk>default</disk></hot>
          <cold><disk>s3_cold_cache</disk></cold>
        </volumes>
      </hot_cold>
    </policies>
  </storage_configuration>
</clickhouse>use_environment_credentialscho ClickHouse dùng IAM role của pod hoặc instance, nên không có key nào trong cấu hình. Trên EKS đó là Pod Identity hoặc IRSA.- Cache disk giữ dữ liệu S3 vừa đọc trên đĩa local, nên query lần hai trên cùng khoảng “tháng trước” không phải chịu độ trễ S3 lần nữa.
- Đừng đặt S3 lifecycle rule để expire hay transition object trên bucket này. ClickHouse theo dõi từng object trong metadata của nó, và một object bị xoá sau lưng nó là một part hỏng. Hãy để mệnh đề
TTL … DELETElo việc xoá. ttl_only_drop_parts = 1khiến việc hết hạn xoá nguyên part thay vì viết lại từng dòng. Kết hợp với partition theo ngày, xoá ngày thứ 366 chỉ còn là một thao tác metadata.
Pipeline với Vector
Aggregator, đọc từ Kafka và ghi vào ClickHouse:
sources:
  kafka_logs:
    type: kafka
    bootstrap_servers: "b-1.logs.xxxx.kafka.ap-southeast-1.amazonaws.com:9096"
    group_id: vector-clickhouse
    topics: ["logs.raw"]
    auto_offset_reset: earliest
    decoding:
      codec: json
    sasl:
      enabled: true
      mechanism: SCRAM-SHA-512
      username: "${KAFKA_USER}"
      password: "${KAFKA_PASSWORD}"
    tls:
      enabled: true

transforms:
  shape:
    type: remap
    inputs: ["kafka_logs"]
    source: |
      body = string(.message) ?? encode_json(.message)
      # che secret rõ ràng trước khi lưu suốt một năm
      body = redact(body, filters: [r'(?i)(password|token|secret)=\S+'])
      # dựng event mới: chỉ các cột trong schema rời khỏi aggregator
      . = compact({
        "Timestamp": .timestamp,
        "ServiceName": .kubernetes.pod_labels."app.kubernetes.io/name" || .kubernetes.container_name || "unknown",
        "SeverityText": upcase(string(.level) ?? "INFO"),
        "TraceId": .trace_id,
        "Body": body,
        "ResourceAttributes": {
          "k8s.namespace.name": .kubernetes.pod_namespace,
          "k8s.pod.name": .kubernetes.pod_name,
          "k8s.node.name": .kubernetes.pod_node_name
        }
      })

sinks:
  clickhouse:
    type: clickhouse
    inputs: ["shape"]
    endpoint: "http://clickhouse-logs.logging.svc:8123"
    database: otel
    table: otel_logs
    format: json_each_row
    compression: zstd
    skip_unknown_fields: true
    date_time_best_effort: true
    auth:
      strategy: basic
      user: vector
      password: "${CLICKHOUSE_PASSWORD}"
    batch:
      max_bytes: 20000000   # ~20 MB mỗi lần insert
      timeout_secs: 5
    buffer:
      type: disk
      max_size: 10737418240 # 10 GiB trên PVC của aggregator
      when_full: block
    acknowledgements:
      enabled: true
Điểm quan trọng:
- Kích thước lô là tất cả. ClickHouse muốn vài lần insert lớn, không phải hàng nghìn lần insert nhỏ. Mỗi lần insert tạo một part, và quá nhiều part nhỏ sẽ dẫn đến lỗi nổi tiếng
Too many parts. Mặc định của Vector làbatch.max_bytes10 MB, timeout 1 giây. Với log, tăng timeout lên vài giây thường không sao. acknowledgements.enabled: truecùng Kafka source nghĩa là offset chỉ được commit sau khi ClickHouse nhận lô. Aggregator có crash thì Kafka gửi lại.- Disk buffer với
when_full: blocktạo back-pressure lên việc đọc Kafka thay vì vứt event. - Async insert (
query_settings.async_insert_settings.enabled) dành cho tình huống ngược lại: nhiều client mỗi bên gửi lô nhỏ, để ClickHouse tự gom ở phía server. Với vài aggregator đã gửi lô 10–20 MB thì không cần. skip_unknown_fieldscho phép producer thêm field mà không làm hỏng insert. Field nào không có trong schema sẽ bị bỏ, nên hãy đưa field quan trọng vàoLogAttributes.
Truy vấn
95% trường hợp: lọc theo service và thời gian, rồi tìm theo token.
SELECT Timestamp, ServiceName, K8sNamespace, Body
FROM otel.otel_logs
WHERE ServiceName = 'checkout'
  AND Timestamp >= now() - INTERVAL 30 MINUTE
  AND hasAllTokens(Body, ['connection', 'refused'])
ORDER BY Timestamp DESC
LIMIT 200;
text index được dùng bởi hasAnyTokens / hasAllTokens (hai hàm được khuyến nghị), hasToken, = / IN, LIKE / match, startsWith / endsWith và các hàm map. Nó không được dùng cho NOT LIKE / NOT IN, nên điều kiện phủ định sẽ phải quét.
Chỗ ClickHouse bỏ xa Elasticsearch là phân tích bằng SQL thuần:
-- tỉ lệ lỗi theo service theo phút
SELECT toStartOfMinute(Timestamp) AS t,
       ServiceName,
       countIf(SeverityText = 'ERROR') / count() AS error_ratio
FROM otel.otel_logs
WHERE Timestamp >= now() - INTERVAL 3 HOUR
GROUP BY t, ServiceName
ORDER BY t;

-- top "dạng" lỗi: gộp số và id để các message giống nhau về chung nhóm
SELECT replaceRegexpAll(Body, '[0-9a-f]{8,}|\\d+', '?') AS pattern,
       count() AS n,
       any(Body) AS example
FROM otel.otel_logs
WHERE SeverityText = 'ERROR' AND Timestamp >= now() - INTERVAL 1 DAY
GROUP BY pattern
ORDER BY n DESC
LIMIT 20;
Xem schema nén tốt đến đâu, theo từng cột:
SELECT name,
       formatReadableSize(sum(data_compressed_bytes))   AS compressed,
       formatReadableSize(sum(data_uncompressed_bytes)) AS raw,
       round(sum(data_uncompressed_bytes) / sum(data_compressed_bytes), 1) AS ratio
FROM system.columns
WHERE database = 'otel' AND table = 'otel_logs_local'
GROUP BY name
ORDER BY sum(data_compressed_bytes) DESC;
Kích thước theo cột chỉ có với part dạng wide. Bảng test nhỏ dùng part compact nên hiện toàn số 0, còn part cỡ production thì là wide. Body gần như luôn là cột lớn nhất. Nếu một service ghi stack trace dài và lặp lại, byte nằm hết ở đó, và sửa cách log còn rẻ hơn mọi codec.
Đa region: log ở yên, query di chuyển
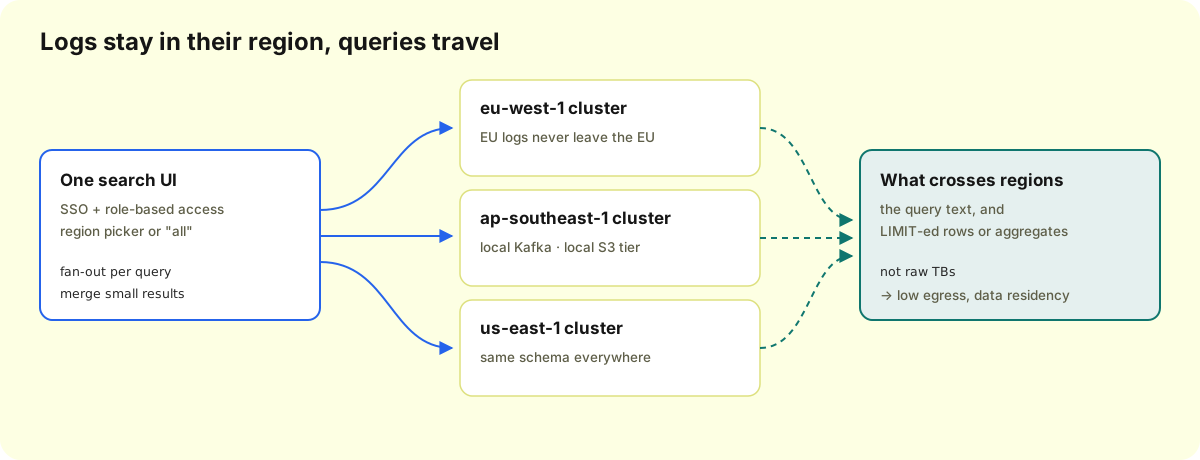
Đẩy mọi dòng log về một region trung tâm vừa tốn kém (egress) vừa thường không được phép (data residency). Thay vào đó, hãy chạy toàn bộ pipeline theo từng region, rồi cho mọi người một chỗ duy nhất để tìm:
- Một định nghĩa cluster trải qua các region: một mục
remote_servers, ví dụlogs_global, liệt kê mọi shard của các region cùng replica của chúng. Một bảngDistributed(logs_global, otel, otel_logs_local)trên một node “query” nhỏ sẽ gửi query đi khắp nơi. Mỗi region lọc và tổng hợp tại chỗ, rồi chỉ gửi kết quả về. Bậtskip_unavailable_shards = 1cho user dùng bảng này, để một region sập chỉ làm kết quả tìm kiếm thiếu đi chứ không làm hỏng cả query. - Hoặc để UI làm: HyperDX và Grafana có thể giữ mỗi region một data source, người dùng chọn region hoặc query song song.
- Phân quyền: đặt UI sau SSO và map group sang user hoặc role của ClickHouse, dùng row policy (ví dụ
ServiceName IN (…)cho từng team) và settings profile chỉ đọc cómax_execution_time,max_memory_usage. Một câuSELECT *trên cả năm của một người không được phép làm sập cụm của tất cả mọi người.
Chuyển đổi không cần big bang
- Ghi song song. Thêm sink ClickHouse cạnh sink Elasticsearch hiện có trong Vector (hoặc Logstash/Fluent Bit). Cả hai nhận cùng luồng dữ liệu từ Kafka với consumer group khác nhau.
- Đối chiếu. So số lượng theo service theo giờ giữa hai hệ thống. Dựng lại các dashboard và alert quan trọng nhất. Cho đội on-call dùng UI mới trong một vài sự cố thật.
- Chuyển phía đọc. Trỏ dashboard, alert, runbook sang ClickHouse. Giữ Elasticsearch ở chế độ chỉ đọc.
- Để Elasticsearch tự hết hạn. Dừng sink ES và để retention hiện có tự xoá dữ liệu, hoặc snapshot sang S3 nếu compliance yêu cầu. Backfill lịch sử sang ClickHouse hiếm khi đáng công.
Những cái bẫy
Too many parts: gần như luôn do insert nhỏ. Xemsystem.partstheo partition, rồi tăng kích thước lô hoặc timeout. Đừng “sửa” bằng cách nâng giới hạn.ORDER BYsai thì sửa rất đắt. Đổi nó nghĩa là tạo bảng mới và copy dữ liệu. Hãy nhìn các điều kiện lọc thật trước khi chọn.- Bùng nổ key trong Map: nếu producer nhét request ID hay user ID vào key của attribute, cột Map sẽ phình không giới hạn. Chuẩn hoá trong transform của Vector.
- Không có relevance, không có fuzzy:
Body LIKE '%timeot%'sẽ không ra “timeout”. Người dùng quen Kibana nên biết trước đây là tìm token chính xác. - Điều kiện phủ định không dùng text index (
NOT LIKE,NOT IN). Hãy thu hẹp theo service và thời gian trước. - Xoá không miễn phí. “Xoá log của user này” nghĩa là lightweight
DELETEhoặc mutation, mà ở quy mô này thì rất đắt. Ưu tiên che dữ liệu ngay lúc ingest, và giữ retention là công cụ xoá chính. - Keeper là thành phần sống còn. Chạy trên node riêng (3 hoặc 5 node), trải qua nhiều zone, đĩa nhanh. Keeper mất quorum thì các bảng replicated chuyển sang chỉ đọc.
- Part khổng lồ: một part vượt khoảng 4,29 tỷ dòng sẽ khiến text index rơi về quét toàn bộ. Partition theo ngày trên từng shard thường giữ bạn ở mức thấp hơn nhiều.
- Query chạy lâu giữ part lại: query giữ tham chiếu tới mọi part nó có thể đọc, nên part cũ không xoá được cho tới khi query kết thúc, kể cả bản local của part mà TTL đã chuyển sang S3. Hãy alert khi query đã bị huỷ mà vẫn chạy. Xem sự cố production bên dưới.
Từ production: query treo đã giữ lại 1,1 TiB
Mọi thứ ở trên là phần thiết kế. Đây là chuyện xảy ra khi một mắt xích trục trặc. Cluster chính là cluster trong bài: 4 shard × 2 replica, dữ liệu mới ghi vào SSD local, và rule TTL chuyển part sang S3 khoảng bảy ngày sau dòng mới nhất trong part.
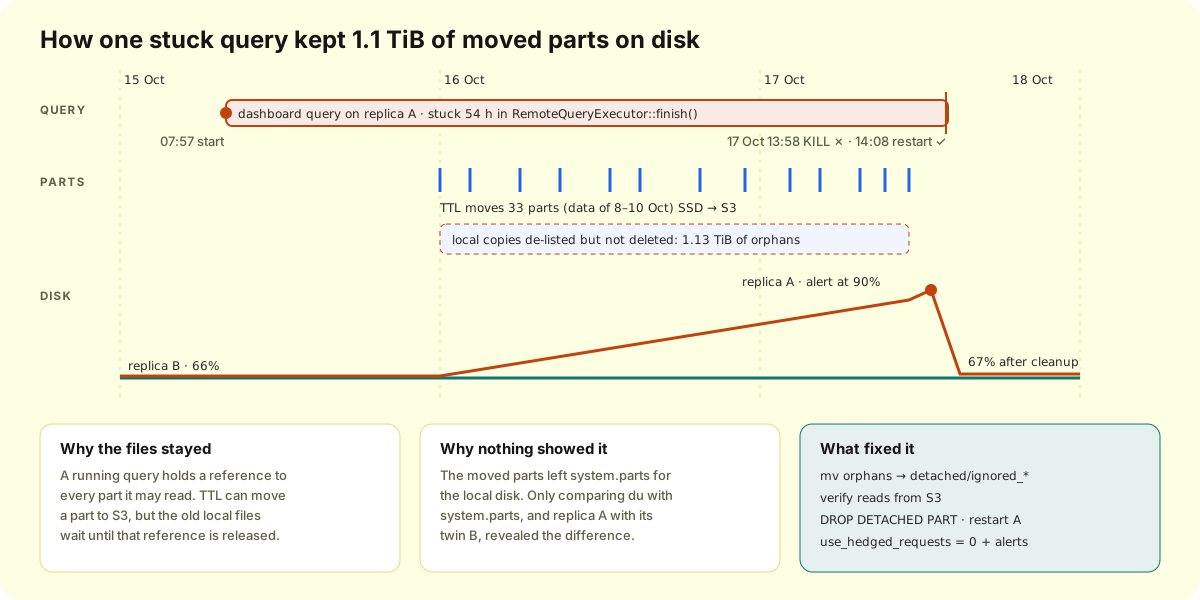
Triệu chứng. Chiều 17/10, alert disk báo một replica (A) đã dùng 90% (5,68 TiB). Replica còn lại trong cùng shard (B) chỉ ở 66%. system.disks cho thấy bảy replica kia dùng từ 4,45 đến 4,59 TiB, riêng A dùng 5,66 TiB.
Đi tìm phần dư thừa. A và B là bản sao của nhau, nên chỗ nào khác nhau thì chỗ đó là rác. Part active giống hệt nhau đến từng byte. Part inactive, part detached và S3 cache cộng lại chỉ khoảng 67 GiB. Hơn 1 TiB còn lại thì không bảng hệ thống nào báo. Chạy du thì ra một bảng, bảng log lớn nhất: 4,2 T trên A, 3,0 T trên B. So các thư mục part trên disk với những gì ClickHouse biết thì tìm ra:
cd <local-disk-path>/store/<prefix>/<table-uuid>
ls -1 | grep -E '^[0-9]{8}_' | sort > /tmp/disk.txt
clickhouse-client -q "SELECT name FROM system.parts
  WHERE database='<db>' AND table='<table>' AND disk_name='<local_disk>'" | sort > /tmp/ch.txt
comm -23 /tmp/disk.txt /tmp/ch.txt   # có trên disk, ClickHouse không biết
A có 33 thư mục không nằm trong system.parts của disk local: 1.158,69 GiB, toàn bộ thuộc các partition 08–10/10. B không có cái nào. Cả 33 đều là part đang active, chỉ có điều nằm trên disk S3. system.part_log ghi nhận mỗi part có một lần MovePart thành công vào ngày 16 hoặc 17/10, nhưng không có RemovePart nào. TTL đã chuyển chúng sang S3, còn bản local thì cứ thế nằm lại.
Nguyên nhân. ClickHouse chỉ xoá file của một part khi không còn gì tham chiếu tới nó. Trên A, những part inactive hết hạn từ 07:58 ngày 15/10 vẫn còn đó với refcount = 2. Trên B, part inactive biến mất sau vài phút. system.processes cho biết thứ gì đang giữ chúng: một query dashboard đã chạy 194.158 giây (khoảng 54 giờ) và mới đọc được 3,1 triệu dòng. system.stack_trace cho thấy nó nằm trong epoll bên trong RemoteQueryExecutor::finish(), chờ một hedged connection tới replica khác, chờ một phản hồi không bao giờ tới. Lúc đó A ghi rất nhiều lỗi Broken pipe trên các kết nối tới replica khác, nên nhiều khả năng thủ phạm là một kết nối “nửa sống nửa chết”. Điều này chưa chứng minh được.
Query đang chạy giữ tham chiếu tới mọi part nó có thể đọc. Các part bị merge sau khi query bắt đầu dồn lại thành part inactive (291 part, khoảng 88 GiB, trong khi B chỉ có 175 part và 6,5 GiB). Rồi TTL chuyển 33 part lớn sang S3: ClickHouse gạch bản local khỏi danh sách part nhưng không xoá được file. Đó chính là 1,13 TiB mà không bảng hệ thống nào hiển thị. Tên partition là ngày của dữ liệu, không phải ngày move, nên query từ 15/10 mới giữ dữ liệu của 08–10/10: sáng hôm đó các part này vẫn còn trên SSD, và chỉ được move một tuần sau dòng mới nhất của chúng. Nếu không restart, các ngày sau cũng sẽ lần lượt thành orphan khi tới hạn move.
Hai lưới an toàn không bắt được. KILL QUERY bật is_cancelled = 1, nhưng thread đang kẹt trong epoll không bao giờ kiểm tra cờ đó, nên query vẫn chạy. Profile của user dashboard vốn đã đặt max_execution_time = 60, nhưng giới hạn này chỉ được kiểm tra khi pipeline đang xử lý dữ liệu, mà query này đã ngừng xử lý từ lâu.
Dọn dẹp mà không mất dữ liệu. Xoá các thư mục mồ côi trước rồi mới restart: vừa giải phóng dung lượng ngay, vừa tránh phải thử trên production xem bảng có load được không khi một part nằm cả trên SSD lẫn S3.
-
Tạo lại danh sách mồ côi và kiểm tra từng part trong 33 part đều đang active trên disk S3 và có metadata ở đó.
-
Chuyển chứ không xoá. Cùng filesystem nên thao tác tức thì và hoàn tác dễ dàng:
while read p; do mv "$p" "detached/ignored_$p"; done < /tmp/orphan.txt -
Lúc này ClickHouse thấy chúng trong
system.detached_parts(1,13 TiB). Kiểm tra dữ liệu ba ngày bị ảnh hưởng vẫn đọc đúng từ S3, rồi xoá qua ClickHouse:ALTER TABLE <db>.<table> DROP DETACHED PART 'ignored_<name>' SETTINGS allow_drop_detached = 1; -
A giảm từ 5,66 TiB xuống 4,6 TiB (90% → 67%).
KILL QUERY … ASYNCvẫn không dừng được query, nên sau khi lưu stack trace và kiểm tra B vẫn khoẻ (is_readonly = 0, không trễ replication, không có orphan mới), pod của A được restart. Pod lên lại trên cùng volume, đồng bộ replication xong và tự dọn các part inactive cũ.
Những gì sẽ thay đổi. Alert disk đã làm đúng việc của nó, nhưng chỉ kêu ở mức 90%, hai ngày sau khi nguyên nhân xuất hiện. Mục tiêu là bắt được ngay từ nguyên nhân. Trước hết, không cho query dashboard đi qua đoạn code đã treo. Với 2 replica mỗi shard, hedged requests gần như không mang lại gì:
profiles:
  <dashboard_profile>:
    max_execution_time: 60
    use_hedged_requests: 0
Sau đó thêm alert cho những dấu hiệu xuất hiện trước khi disk đầy:
| Alert | Kêu khi | Mức độ |
|---|---|---|
| Query đã huỷ mà vẫn chạy | is_cancelled = 1 và elapsed > 600 |
Critical |
| Query chạy quá lâu | elapsed > 3600 trên bất kỳ replica nào |
Warning |
| Part inactive tồn lâu | part inactive có remove_time cũ hơn 1 giờ |
Warning |
| Dung lượng ClickHouse không quản lý | dung lượng disk đã dùng trừ bytes_on_disk của part vượt 200 GiB |
Warning |
| Hai replica lệch nhau | dung lượng đã dùng lệch quá 10% trong cùng shard | Warning |
Alert đầu tiên là cái sẽ bắt được đúng sự cố lần này. Query cho ba alert đầu:
-- query đã huỷ mà vẫn chạy, và query chạy quá lâu
SELECT hostName() AS host, query_id, user, elapsed, is_cancelled
FROM clusterAllReplicas('<cluster>', system.processes)
WHERE elapsed > 3600 OR (is_cancelled AND elapsed > 600);

-- part inactive lẽ ra đã bị xoá từ lâu
SELECT hostName() AS host, database, table, count() AS parts, min(remove_time) AS oldest
FROM clusterAllReplicas('<cluster>', system.parts)
WHERE NOT active AND remove_time < now() - INTERVAL 1 HOUR
GROUP BY host, database, table;
Với dung lượng không được quản lý, chạy câu này trên từng replica và đặt ngưỡng cao hơn kích thước cache local:
SELECT
  (SELECT total_space - free_space FROM system.disks WHERE name = '<local_disk>')
  - (SELECT sum(bytes_on_disk) FROM system.parts WHERE disk_name = '<local_disk>') AS untracked_bytes;
Rút ra được gì.
- So một replica với replica còn lại của cùng shard. Hai bên lẽ ra giống hệt nhau, nên chỗ nào khác chính là chỗ có vấn đề.
- Bảng hệ thống chỉ hiển thị những gì ClickHouse còn đang quản lý. Lần này rác lại chính là những thứ nó đã thôi quản lý, nên phải tự so
duvớisystem.parts. - Một query không bao giờ kết thúc không chỉ tốn CPU. Nó giữ các part cũ lại, và khi có TTL move thì đó có thể là cả một bản sao thứ hai của mọi thứ đã được chuyển đi.
KILLkhông phải lúc nào cũng có tác dụng. Một query đã bị huỷ mà mười phút sau vẫn còn thì cần có người được báo.
Còn hai điều chưa rõ: lỗi treo này có phải lỗi đã biết của ClickHouse không (sẽ tìm trên issue tracker bằng stack trace, chưa có thì báo lỗi), và client có ghi đè max_execution_time cho query đó không (xem trong system.query_log).
Tổng kết
Log là bài toán dạng cột theo chuỗi thời gian, mà lâu nay ta lại giải bằng một search engine. Chuyển chúng sang ClickHouse với:
- schema theo chuẩn OTel có
ORDER BYkhớp với cách bạn lọc, textindex để tìm theo token,- Vector và Kafka để ingest bền vững theo lô, và
- TTL tiering sang S3.
Bạn sẽ có retention dài hơn, SQL thật sự và hoá đơn nhỏ hơn nhiều. Hãy giữ Elasticsearch, hoặc OpenSearch, cho những nơi thực sự cần full-text search có xếp hạng.
Nguồn
- Tổng quan ClickStack (ClickHouse, HyperDX, OTel collector): https://clickhouse.com/docs/use-cases/observability/clickstack/overview
- Thiết kế schema cho observability: https://clickhouse.com/docs/use-cases/observability/schema-design
- Full-text search với text index: https://clickhouse.com/docs/engines/table-engines/mergetree-family/invertedindexes
- Tách storage và compute (S3 disk, cache): https://clickhouse.com/docs/guides/separation-storage-compute
- TTL của MergeTree và
ttl_only_drop_parts: https://clickhouse.com/docs/engines/table-engines/mergetree-family/mergetree#table_engine-mergetree-ttl - Vector ClickHouse sink: https://vector.dev/docs/reference/configuration/sinks/clickhouse/
- Vector Kafka source: https://vector.dev/docs/reference/configuration/sources/kafka/
- ClickHouse
system.parts: https://clickhouse.com/docs/operations/system-tables/parts - ClickHouse
system.part_log: https://clickhouse.com/docs/operations/system-tables/part_log ALTER TABLE … DROP DETACHED PART: https://clickhouse.com/docs/sql-reference/statements/alter/partition#drop-detached-partitionpartKILL QUERY: https://clickhouse.com/docs/sql-reference/statements/kill- Setting
use_hedged_requests: https://clickhouse.com/docs/operations/settings/settings#use_hedged_requests


Bình luận