SLO 101: SLI, error budget và cảnh báo burn rate chỉ kêu khi thật sự cần
Một SLO đầu tiên làm thực tế với Prometheus: chọn SLI mà người dùng thật sự cảm nhận, biến 99.9% thành error budget, viết recording rule, thêm cảnh báo burn rate nhiều cửa sổ kèm unit test, và thống nhất error budget policy.
Nếu bạn không đo được mức độ “ổn” của hệ thống, mọi cuộc tranh luận về reliability chỉ là cảm tính.
Phần lớn các team không thiếu cảnh báo. Họ có quá nhiều: CPU trên 80%, một pod restart, latency tăng vọt 30 giây lúc 3 giờ sáng. Đa số những lần bị gọi dậy đó chẳng ảnh hưởng gì tới người dùng, còn những lần thật sự quan trọng thì lại chìm trong đống nhiễu. SLO giải quyết chuyện này bằng một câu hỏi duy nhất: người dùng có đang nhận đúng trải nghiệm ta đã hứa không, và ta đang tiêu hết khoảng dư cho phép lỗi nhanh đến mức nào?
Bài này dựng trọn vẹn một SLO cho một HTTP API với Prometheus: SLI, error budget, recording rule, cảnh báo, unit test chứng minh cảnh báo kêu đúng lúc, và policy để con số đó thực sự có ích.
Ba khái niệm cốt lõi
| Khái niệm | Ý nghĩa | Ví dụ |
|---|---|---|
| SLI (chỉ số) | Tỉ lệ sự kiện tốt trên tổng sự kiện, đo ở nơi người dùng cảm nhận | Tỉ lệ request không trả về 5xx |
| SLO (mục tiêu) | Mục tiêu cho SLI trong một khoảng thời gian | 99.9% trong 30 ngày trượt |
| Error budget | Phần SLO cho phép lỗi: 1 − SLO |
0.1% request ≈ 43 phút sập hoàn toàn / 30 ngày |
Budget mới là phần hữu ích. 99.9% không có nghĩa là “cố gắng hết sức”. Nó có nghĩa là bạn được phép lỗi 1 request trong 1.000, và mọi thứ khác xuất phát từ việc bạn tiêu phần đó nhanh hay chậm.
| SLO | Error budget | Thời gian sập hoàn toàn được phép mỗi 30 ngày |
|---|---|---|
| 99% | 1% | 7 giờ 12 phút |
| 99.5% | 0.5% | 3 giờ 36 phút |
| 99.9% | 0.1% | 43 phút 12 giây |
| 99.95% | 0.05% | 21 phút 36 giây |
| 99.99% | 0.01% | 4 phút 19 giây |
Đừng nhắm tới 100%. Qua Wi-Fi và điện thoại của chính mình, người dùng không phân biệt được 99.99% với 100%, còn mục tiêu 100% nghĩa là bạn không bao giờ được deploy, migrate hay thử nghiệm gì. Hãy chọn con số thấp nhất mà người dùng vẫn hài lòng, rồi siết lại nếu họ phàn nàn.
Bước 1: chọn SLI mà người dùng thật sự cảm nhận
Bắt đầu với một hoặc hai SLI cho mỗi service phục vụ người dùng:
- Availability: tốt = không phải 5xx (tự quyết xem 429 có tính là xấu không: nếu người dùng coi đó là lỗi thì có).
- Latency: tốt = được phục vụ nhanh hơn một ngưỡng có ý nghĩa với người dùng, ví dụ 300 ms cho một API. Dùng tỉ lệ request dưới ngưỡng, không dùng trung bình hay một gauge p99.
Đo càng gần người dùng càng tốt: load balancer hay ingress thấy được cả những lỗi chưa bao giờ tới được pod. Loại bỏ những gì không phải traffic thật của người dùng (health check, batch job nội bộ), nếu không SLO sẽ trông đẹp hơn thực tế.
Bước 2: recording rule
Một cảnh báo phải tính rate(...[3d]) trên counter thô mỗi phút vừa tốn tài nguyên vừa khó đọc. Hãy tính sẵn tỉ lệ lỗi cho từng cửa sổ thời gian bằng recording rule, đặt tên theo kiểu level:metric:operation của Google SRE Workbook:
groups:
  - name: slo:api:recordings
    rules:
      - record: job:slo_errors_per_request:ratio_rate5m
        expr: |
          sum by (job) (rate(http_requests_total{job="api", code=~"5.."}[5m]))
          /
          sum by (job) (rate(http_requests_total{job="api"}[5m]))
      # cùng một rule cho 30m, 1h, 2h, 6h, 1d và 3d: chỉ đổi khoảng thời gian
      - record: job:slo_errors_per_request:ratio_rate1h
        expr: |
          sum by (job) (rate(http_requests_total{job="api", code=~"5.."}[1h]))
          /
          sum by (job) (rate(http_requests_total{job="api"}[1h]))
      # SLI latency: tỉ lệ request nhanh hơn 300 ms
      - record: job:slo_latency_good:ratio_rate5m
        expr: |
          sum by (job) (rate(http_request_duration_seconds_bucket{job="api", le="0.3"}[5m]))
          /
          sum by (job) (rate(http_request_duration_seconds_count{job="api"}[5m]))
Bạn cần bảy cửa sổ cho các cảnh báo bên dưới: 5m, 30m, 1h, 2h, 6h, 1d và 3d. SLI latency chỉ đúng khi 0.3 thực sự là một mốc bucket trong histogram của bạn, nên hãy kiểm tra lại phần instrumentation.
Bước 3: cảnh báo theo burn rate, không theo tỉ lệ lỗi
Burn rate là tốc độ bạn tiêu budget so với nhịp “vừa đúng mục tiêu”. Burn rate bằng 1 tiêu hết budget đúng sau 30 ngày. Burn rate 14.4 tiêu hết trong khoảng 2 ngày.
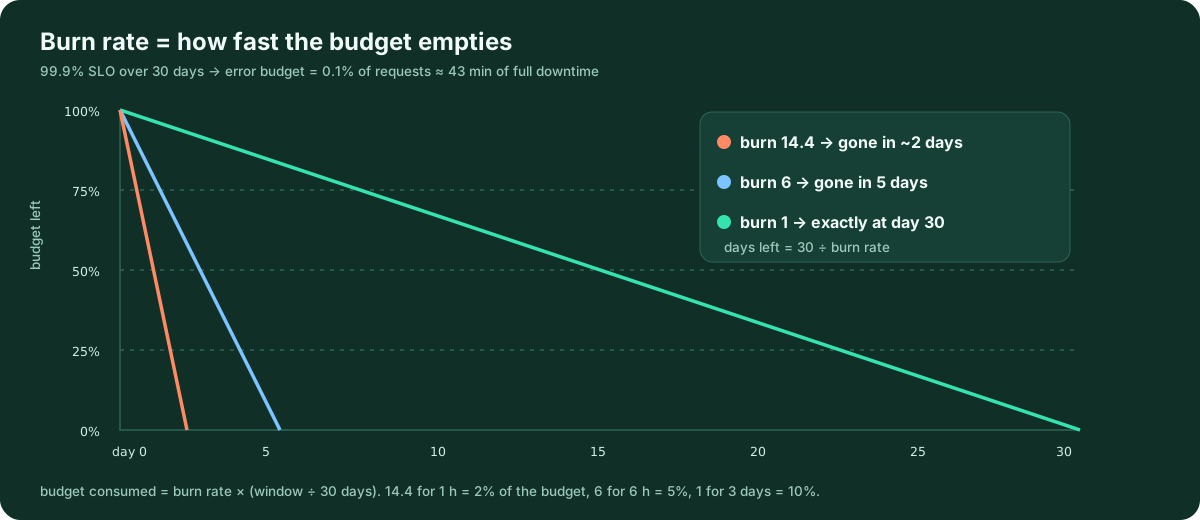
Công thức đáng nhớ là budget đã tiêu = burn rate × (cửa sổ ÷ 30 ngày). Từ đó ra các ngưỡng mà SRE Workbook khuyến nghị làm điểm khởi đầu cho SLO 99.9%:
| Mức độ | Cửa sổ dài | Cửa sổ ngắn | Burn rate | Budget đã tiêu |
|---|---|---|---|---|
| Page | 1 giờ | 5 phút | 14.4 | 2% |
| Page | 6 giờ | 30 phút | 6 | 5% |
| Ticket | 1 ngày | 2 giờ | 3 | 10% |
| Ticket | 3 ngày | 6 giờ | 1 | 10% |
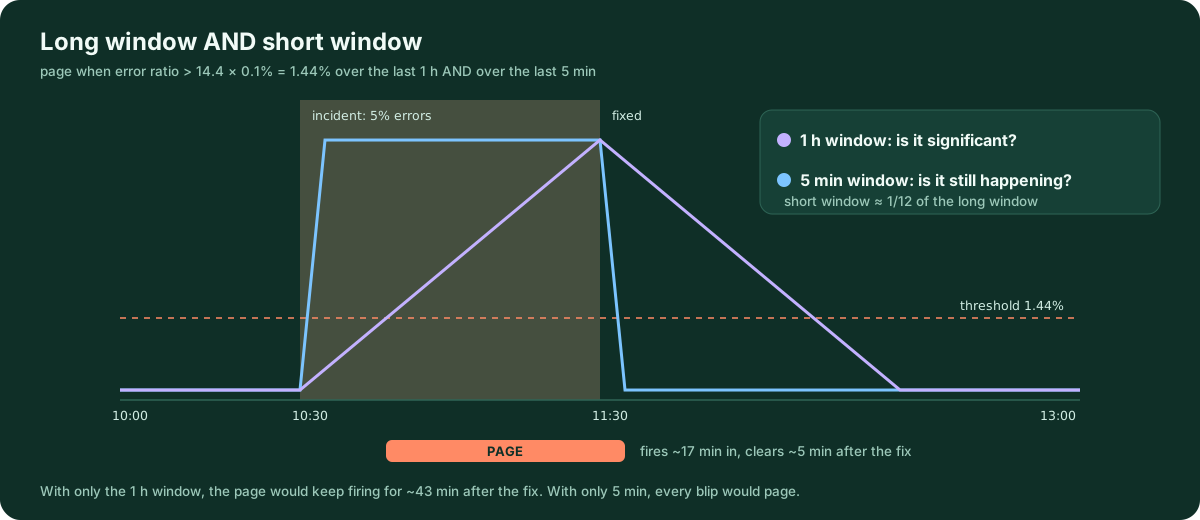
Mỗi cảnh báo cần cả hai cửa sổ cùng vượt ngưỡng:
  - name: slo:api:alerts
    rules:
      - alert: APIErrorBudgetBurn
        expr: |
          (
            job:slo_errors_per_request:ratio_rate1h{job="api"} > (14.4 * 0.001)
            and
            job:slo_errors_per_request:ratio_rate5m{job="api"} > (14.4 * 0.001)
          )
          or
          (
            job:slo_errors_per_request:ratio_rate6h{job="api"} > (6 * 0.001)
            and
            job:slo_errors_per_request:ratio_rate30m{job="api"} > (6 * 0.001)
          )
        labels:
          severity: page
        annotations:
          summary: "api is burning its 30-day error budget fast (2% in 1h or 5% in 6h)"
      - alert: APIErrorBudgetBurnSlow
        expr: |
          (
            job:slo_errors_per_request:ratio_rate1d{job="api"} > (3 * 0.001)
            and
            job:slo_errors_per_request:ratio_rate2h{job="api"} > (3 * 0.001)
          )
          or
          (
            job:slo_errors_per_request:ratio_rate3d{job="api"} > 0.001
            and
            job:slo_errors_per_request:ratio_rate6h{job="api"} > 0.001
          )
        labels:
          severity: ticket
        annotations:
          summary: "api will run out of error budget before the 30-day window ends"
0.001 là error budget (1 − 0.999). Nếu đổi SLO, hãy đổi ở mọi chỗ, hoặc để một công cụ sinh rule làm việc đó (Bước 5).
Bước 4: chứng minh cảnh báo hoạt động bằng promtool
Rule cảnh báo cũng là code, nên hãy test nó. promtool test rules chạy chuỗi dữ liệu giả qua rule của bạn và kiểm tra cảnh báo nào được bật:
# slo-test.yml: chạy bằng `promtool test rules slo-test.yml`
rule_files: [slo-rules.yml]
evaluation_interval: 1m
tests:
  # 5% request lỗi: gấp 50 lần nhịp budget → page
  - interval: 1m
    input_series:
      - series: 'http_requests_total{job="api",code="200"}'
        values: '0+950x180'
      - series: 'http_requests_total{job="api",code="500"}'
        values: '0+50x180'
    alert_rule_test:
      - eval_time: 20m
        alertname: APIErrorBudgetBurn
        exp_alerts:
          - exp_labels: {job: api, severity: page}
            exp_annotations:
              summary: "api is burning its 30-day error budget fast (2% in 1h or 5% in 6h)"
  # 0.5% lỗi: burn 5x → ticket, nhưng không page
  - interval: 1m
    input_series:
      - series: 'http_requests_total{job="api",code="200"}'
        values: '0+995x300'
      - series: 'http_requests_total{job="api",code="500"}'
        values: '0+5x300'
    alert_rule_test:
      - eval_time: 240m
        alertname: APIErrorBudgetBurn
        exp_alerts: []
      - eval_time: 240m
        alertname: APIErrorBudgetBurnSlow
        exp_alerts:
          - exp_labels: {job: api, severity: ticket}
            exp_annotations:
              summary: "api will run out of error budget before the 30-day window ends"
Rule và test trong bài này đều qua promtool check rules và promtool test rules với Prometheus 3.15, kể cả một trường hợp thứ ba không in ở đây: lỗi 0.05%, nằm trong SLO, không bật cảnh báo nào. Hãy chạy các test này trong CI để không ai làm hỏng cảnh báo SLO chỉ vì gõ nhầm.
Bước 5: để công cụ sinh rule thay bạn
Bảy recording rule và hai cảnh báo cho mỗi SLO thì ổn với một service, nhưng rất mệt với năm mươi service. Sloth và Pyrra sinh trọn bộ rule từ một spec ngắn. Với Sloth:
version: "prometheus/v1"
service: "api"
labels:
  owner: "platform-team"
slos:
  - name: "requests-availability"
    objective: 99.9
    description: "99.9% of API requests succeed over 30 days."
    sli:
      events:
        error_query: sum(rate(http_requests_total{job="api", code=~"5.."}[{{.window}}]))
        total_query: sum(rate(http_requests_total{job="api"}[{{.window}}]))
    alerting:
      name: APIHighErrorRate
      labels:
        category: "availability"
      annotations:
        summary: "api is burning its error budget"
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
          severity: ticket
sloth generate -i api-slo.yml -o api-rules.yml biến spec này thành 17 rule (đã chạy thử với Sloth 0.16): các cửa sổ SLI, đúng bộ cảnh báo page và ticket nhiều cửa sổ như trên, và các chuỗi dùng ngay cho dashboard như slo:period_error_budget_remaining:ratio. Trên Kubernetes có Prometheus Operator, cả hai công cụ đều chạy được dạng controller, biến một custom resource SLO thành PrometheusRule.
Nếu làm dashboard mà không dùng công cụ sinh rule, “budget còn lại trong 30 ngày qua” là:
1 - (
  sum(increase(http_requests_total{job="api", code=~"5.."}[30d]))
  /
  sum(increase(http_requests_total{job="api"}[30d]))
) / 0.001
Bước 6: error budget policy
Một con số không ai hành động theo thì chỉ để trang trí. Hãy viết ra, trước sự cố đầu tiên, mỗi mức budget nghĩa là gì:
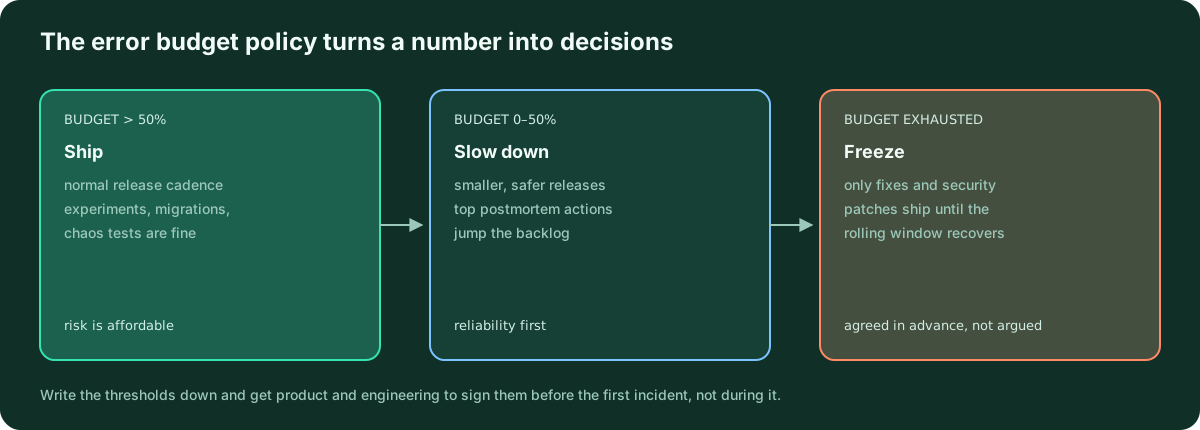
Con số ngưỡng cụ thể không quan trọng bằng việc mọi người đã thống nhất từ trước. Hãy thống nhất luôn những gì không tính vào budget, ví dụ một sự cố trên toàn nhà cung cấp mà bạn không thể giảm thiểu, và ai được quyền cho ngoại lệ.
Những cái bẫy
- Traffic thấp: với 10 request mỗi giờ, một lỗi là tỉ lệ lỗi 10% và burn 100 lần. Hãy dùng cửa sổ dài hơn, gộp các service nhỏ cùng chung failure domain, hoặc thêm synthetic probe. Đừng page vì một request.
- Cửa sổ trượt và cửa sổ theo lịch: cửa sổ trượt 30 ngày hồi dần dần, còn tháng theo lịch thì reset vào ngày 1. Cửa sổ trượt tốt hơn cho cảnh báo, theo lịch thì dễ báo cáo hơn. Chọn một và ghi rõ trên dashboard.
- Counter reset và mất series: nếu API ngừng báo metric hoàn toàn, tỉ lệ không có dữ liệu và không cảnh báo nào kêu. Hãy đặt kèm mỗi cảnh báo SLO một cảnh báo
absent()hoặc “target down”. - Quá nhiều SLO: ba SLO mỗi service mà mọi người thực sự nhìn còn hơn hai mươi SLO không ai hiểu. Bắt đầu từ những user journey quan trọng nhất.
- Phụ thuộc: SLO của bạn không thể cao hơn tích SLO của những thứ bạn gọi đồng bộ, trừ khi có retry, cache hay fallback. Hai dependency 99.9% nối tiếp nhau cho bạn khoảng 99.8%.
Checklist
- Một hoặc hai SLI cho mỗi service phục vụ người dùng, đo ở biên
- Mục tiêu người dùng chấp nhận được, không phải 100%
- Recording rule cho 5m, 30m, 1h, 2h, 6h, 1d, 3d
- Cảnh báo burn rate nhiều cửa sổ: page khi burn nhanh, ticket khi burn chậm
-
promtool test rulestrong CI - Một cảnh báo mất dữ liệu đặt cạnh mỗi cảnh báo SLO
- Error budget policy được cả product và engineering ký duyệt
- Dashboard hiển thị budget còn lại, được xem lại trong buổi họp vận hành hằng tuần
Nguồn
- Google SRE Book: Service Level Objectives: https://sre.google/sre-book/service-level-objectives/
- Google SRE Workbook: triển khai SLO: https://sre.google/workbook/implementing-slos/
- Google SRE Workbook: cảnh báo theo SLO (burn rate nhiều cửa sổ): https://sre.google/workbook/alerting-on-slos/
- Prometheus recording rules: https://prometheus.io/docs/prometheus/latest/configuration/recording_rules/
- Unit test cho rule của Prometheus: https://prometheus.io/docs/prometheus/latest/configuration/unit_testing_rules/
- Sloth: https://github.com/slok/sloth
- Pyrra: https://github.com/pyrra-dev/pyrra


Bình luận